SEO i rozwój strony · poradnik DoSieci
Robots.txt, noindex i canonical: jak sprawdzić indeksowanie strony?
Strona otwiera się w przeglądarce, a mimo to audyt pokazuje problem z indeksowaniem? Najpierw ustal, którego etapu dotyczy sygnał: pobrania treści, zgody na indeksowanie czy wyboru właściwego adresu. Te trzy sytuacje wymagają różnych działań.
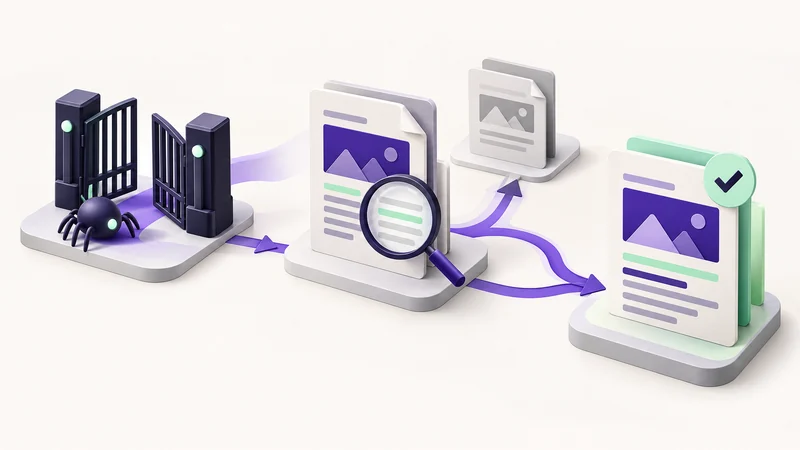
Trzy sygnały, trzy różne pytania
Wyobraź sobie publiczną stronę usługi oraz jej kopię utworzoną na czas przebudowy. Oferta ma być odnajdywana, ale kopia robocza nie powinna trafiać do klientów. Zanim zaczniesz poprawiać wynik, zapisz dla każdego adresu oczekiwany stan. Dzięki temu nie usuniesz celowej blokady tylko po to, by uzyskać więcej zielonych oznaczeń.
| Sygnał | Na jakie pytanie odpowiada? | Czego nie rozstrzyga? |
|---|---|---|
| robots.txt | Czy dany robot może pobrać adres? | Czy adres jest w indeksie? |
| noindex | Czy wyszukiwarka ma wykluczyć odczytaną stronę? | Czy robot już odczytał nową dyrektywę? |
| canonical | Którą wersję treści wskazujemy jako preferowaną? | Czy Google wybrał właśnie ten adres? |
Dokumentacja robots.txt wyjaśnia, dlaczego sam zakaz pobierania nie jest mechanizmem ochrony prywatnych danych. Do treści poufnych stosuj uwierzytelnienie i właściwe uprawnienia.
Co mówi raport DoSieci, a co trzeba potwierdzić osobno?
Raport pokazuje odpowiedź HTTP, odczytane dyrektywy i deklarację canonical. Może również zweryfikować dostępność wskazanego celu. To obserwacje z określonej chwili i konkretnego żądania. Odpowiedź 403 albo 429 może oznaczać ograniczenie dostępu automatu; nie jest dowodem usunięcia podstrony.
Rozwiń dowody i zanotuj dokładny adres końcowy. Wersje z www, bez www, z innym protokołem lub parametrem mogą zwracać różne odpowiedzi. Nie porównuj przypadkiem dwóch innych dokumentów. Zwróć też uwagę na informację o niepełnym HTML lub braku danych.
W Sprawdzaniu adresu URL w Search Console oddziel wynik zapisany w indeksie od testu aktualnego adresu. Datę ostatniego pobrania i canonical wybrany przez Google odczytuj z odpowiedniego raportu; test na żywo nie przewiduje wyboru wersji kanonicznej.
Gdzie szukać niezamierzonego noindex?
Otwórz źródło odpowiedzi HTML i wyszukaj robots, googlebot oraz noindex. Następnie w narzędziach deweloperskich przeglądarki wybierz żądanie dokumentu w panelu Sieć/Network i sprawdź nagłówki odpowiedzi, zwłaszcza X-Robots-Tag. Dyrektywa może pochodzić z innego miejsca niż ustawienie widoczne w edytorze.
<meta name="robots" content="noindex">
X-Robots-Tag: noindex
Jeżeli strona ma być publiczna, sprawdź ustawienia widoczności w CMS, konfigurację wtyczki SEO oraz reguły serwera lub CDN. Właściciel treści powinien najpierw potwierdzić zamiar, a programista lub administrator zmienić właściwe źródło. Nie dodawaj kolejnego znacznika index obok istniejącego noindex jako sposobu naprawy.
Google musi móc pobrać stronę, aby odczytać noindex. Nie łącz w ciemno blokady w robots.txt z oczekiwaniem, że robot zobaczy nową dyrektywę.
Jak sprawdzić canonical bez łączenia różnych stron?
Canonical powinien wynikać z rzeczywistej relacji między dokumentami. Parametr kampanii prowadzący do tej samej oferty to inny przypadek niż dwie usługi o różnych zakresach. Nie kieruj wszystkich podstron na stronę główną. Możesz w ten sposób wysłać sygnał sprzeczny z ich samodzielnym przeznaczeniem.
<link rel="canonical" href="https://example.org/oferta/">Otwórz wskazany adres, porównaj treść i sprawdź jego odpowiedź HTTP. Ustal, czy nie wskazuje dalej innej wersji albo nie zawiera noindex. Następnie porównaj adresy w linkach wewnętrznych i mapie witryny. W małym serwisie najłatwiej przejrzeć reprezentatywną ofertę, artykuł i stronę kategorii przed zmianą całego szablonu.
Canonical jest sygnałem preferencji, dlatego zgodne deklaracje pomagają uniknąć niejasności, ale nie dają kontroli nad każdą decyzją wyszukiwarki.
Alternatywy językowe: jak sprawdzić hreflang?
Jeżeli masz rzeczywiste tłumaczenia tej samej strony, sprawdź także deklaracje hreflang. Każda wersja powinna wymieniać siebie i pozostałe warianty, używać pełnych adresów HTTPS oraz prowadzić do odpowiedniej podstrony, a nie przypadkowej strony głównej. Otwórz każdy zadeklarowany adres i potwierdź zgodność języka oraz wzajemne odsyłacze.
<link rel="alternate" hreflang="pl" href="https://example.org/pl/oferta/">
<link rel="alternate" hreflang="en" href="https://example.org/en/offer/">
To przykład dla dwóch istniejących tłumaczeń. Brak tłumaczenia nie jest powodem do dodawania fikcyjnego adresu. Canonical i hreflang opisują różne relacje: przed połączeniem wersji ustal ich przeznaczenie. W raporcie rozróżnij deklarację od potwierdzonej odpowiedzi celu; timeout lub blokada automatu pozostają nieustalone. Zasady i przykłady znajdziesz w dokumentacji Google o wersjach językowych.
Dlaczego sama mapa witryny nie zamyka sprawy?
Mapa ułatwia przekazanie adresów, które uważasz za ważne. Nie zastępuje działających stron ani sensownego linkowania. Wpis adresu z błędem, blokadą albo sprzecznym canonical nie usuwa przyczyny problemu. Po zmianie sprawdź, czy generator mapy opublikował oczekiwaną wersję URL.
Audyt może zbadać ograniczoną próbkę plików. Komunikat, że adresu nie znaleziono w sprawdzonym zakresie, nie dowodzi nieobecności we wszystkich mapach dużego serwisu. Sprawdź podany limit i ewentualny indeks map. Obecność w sitemap nie gwarantuje pobrania ani indeksacji.
Jak potwierdzić poprawkę i nie wprowadzić regresji?
- Zapisz wcześniejszy dowód oraz oczekiwane przeznaczenie adresu.
- Wprowadź jedną zmianę w jej źródle. Zachowaj kopię ustawienia, aby móc je przywrócić.
- Odśwież właściwą warstwę cache, jeśli zmieniona odpowiedź nadal zawiera stary sygnał.
- Uruchom audyt ponownie i porównaj daty oraz wykryte wartości, nie tylko końcową ocenę.
- Sprawdź aktualną odpowiedź i późniejszy stan w Search Console. Zmiana na serwerze i ponowne przetworzenie przez Google to dwa osobne zdarzenia.
Jeżeli zmieniasz szablon, obejrzyj także stronę, która celowo pozostaje poza wyszukiwarką. Poprawka publicznej oferty nie powinna przypadkiem odsłaniać obszaru klienta ani środowiska testowego.
Lista kontrolna po poprawce
- Ustaliłem, czy ten konkretny adres powinien być publiczny i indeksowalny.
- Sprawdziłem HTML oraz nagłówki odpowiedzi właściwego dokumentu.
- Canonical prowadzi do zamierzonej, dostępnej wersji treści.
- Linki i sitemap wskazują spójne adresy.
- Po zmianie porównałem świeże dowody; indeksację sprawdzam osobno w Search Console.
Pytania i odpowiedzi
Czy brak robots.txt jest błędem SEO?Rozwiń odpowiedźZwiń odpowiedź
Sam brak tego pliku nie dowodzi usterki. Najpierw sprawdź, czy strona jest dostępna, jakie dyrektywy zwraca i czy w ogóle potrzebuje ograniczeń pobierania.
Czy po usunięciu noindex strona pojawi się od razu w Google?Rozwiń odpowiedźZwiń odpowiedź
Nie ma takiej gwarancji. Nowa odpowiedź musi zostać pobrana i przetworzona, a brak noindex jest tylko jednym z warunków. Stan indeksu weryfikuj w Search Console.
Dokumentacja źródłowa
Materiały, na których oparto instrukcje. Dokumentacja narzędzi może się zmieniać; porównuj także datę i zakres swojego pomiaru.